//04 Avaliação e qualidade
Testar um modelo antes de confiar nele
Medi um modelo de decisão em 1.202 documentos por seis cêntimos. O resultado interessa menos do que o método, e o método apanhou-me a mim a tirar a conclusão errada.
TL;DR. Pus um modelo de decisão comercial a responder à mesma pergunta que eu, em 1.202 documentos, por seis cêntimos. Concordou comigo em 71% das vezes e ordena bem, mas o número que devolve não é uma probabilidade fiável: bate-o uma recalibração trivial feita a partir dos meus próprios dados. O que vale deste trabalho não é o veredicto sobre o produto, é o protocolo, e a prova de que ele funciona é ter-me apanhado a mim, a meio, a publicar uma conclusão que não sobreviveu a mais dados.
Contexto
Há uma categoria nova de modelos que não escrevem texto. Recebem um estado e uma pergunta
fechada e devolvem um número entre 0 e 1: “este pedido é urgente?” → 0,87. São rápidos,
custam quase nada e vendem-se com uma promessa específica: as probabilidades são
calibradas, ou seja, quando dizem 0,9, acertam em cerca de nove de cada dez casos.
Essa promessa é a diferença entre uma ferramenta e um enfeite. Se o número for calibrado, podes montar um portão em cima dele: acima de 0,9 age sozinho, abaixo de 0,5 chama um humano. Se não for, o portão é decoração com decimais.
O problema é que a promessa é inverificável de fora. Não há paper, não há curva publicada, e a documentação do fornecedor não recomenda métrica nenhuma para a testar. Só o teu próprio teste responde.
Este artigo é sobre como montar esse teste. Não nomeio o fornecedor, por uma razão que também é uma lição: os termos de serviço de vários fornecedores proíbem publicar benchmarks ou informação de performance sobre o produto. Se planeias publicar a tua avaliação, lê os termos antes de a começar, não depois.
O framework: cinco regras do modo sombra
O desenho chama-se modo sombra: o modelo corre em paralelo com o humano e nunca toca no output. Nada do que ele diz entra num relatório, num ticket ou numa decisão. Só é registado ao lado da resposta humana, para comparação posterior.
1. Selar antes de perguntar
O veredicto humano escreve-se primeiro e fica selado com um hash. O registo da resposta do modelo é recusado pelo motor se não existir um veredicto humano anterior para aquele caso.
Isto não é burocracia. Sem o selo, ao fim de uns meses não se distingue “o modelo acertou” de “eu concordei com o modelo porque li a resposta dele primeiro”. Isso é fuga de dados, não tem correcção retroactiva, e destrói o único motivo de existir do exercício.
Detalhe que importa: se reescreveres o teu veredicto depois de o modelo responder, o selo parte e o caso sai da medição. Não é apagado, é exposto numa lista própria. Uma regra que depende de disciplina não é uma regra.
2. Projectar, não enviar
Nenhum documento viaja. O que viaja é uma projecção: um dicionário construído pelo teu código, com os campos declarados à partida. Se um campo não declarado aparecer no caminho, o motor recusa em vez de o deixar passar.
Projeccao(
    nome="afirmacao_tem_fonte",
    campos=("afirmacao", "tem_citacao", "forma_da_fonte", "tem_numero"),
    construir=_afirmacao,
)
Na projecção acima, a frase sai mas a fonte não: sai só a forma da fonte (caminho, URL ou nenhuma). Por cima disto corre sempre uma redacção de emails, telefones, identificadores fiscais e caminhos de utilizador.
Vantagem lateral que não é lateral: muitas perguntas respondem-se com a forma do documento e não com o conteúdo. Se a projecção for estrutural, o teste deixa de ser um problema de privacidade.
3. Ler o erro contra o ruído, nunca sozinho
Esta é a regra que mais gente falha, e eu falhei-a a meio deste trabalho.
A métrica habitual de calibração é o ECE, o desvio médio entre o que o modelo promete e o que acontece. O problema é que o ECE tem piso de ruído: mesmo um modelo perfeitamente calibrado devolve ECE maior que zero quando tens poucos casos, pela mesma razão que dez lançamentos de uma moeda honesta raramente dão cinco caras.
A métrica de decisão não é o ECE. É o par (ECE observado, percentil 95 do ECE sob calibração perfeita). Esse segundo número simula-se: pegas nas probabilidades que o modelo devolveu, geras milhares de mundos onde ele está certo por construção, e vês que ECE isso produz com o teu N e o teu binning.
O atalho analítico serve para dimensionar antes de recolher:
piso ≈ sqrt(2 · var · B / (π · N))| Casos | Piso de ruído | Só se chama descalibrado acima de |
|---|---|---|
| 50 | 0,083 | ECE 0,15 |
| 150 | 0,073 | ECE 0,15 |
| 400 | 0,066 | ECE 0,09 |
| 800 | 0,047 | ECE 0,06 |
| 2.000 | 0,026 | ECE 0,05 |
Com 150 exemplos, um ECE de 0,07 é indistinguível de calibração perfeita. E detectar um efeito de tamanho δ exige o piso a cerca de metade, ou seja quatro vezes o N que basta para o piso lá chegar: detectar ECE 0,05 pede uns 2.100 casos, não 535.
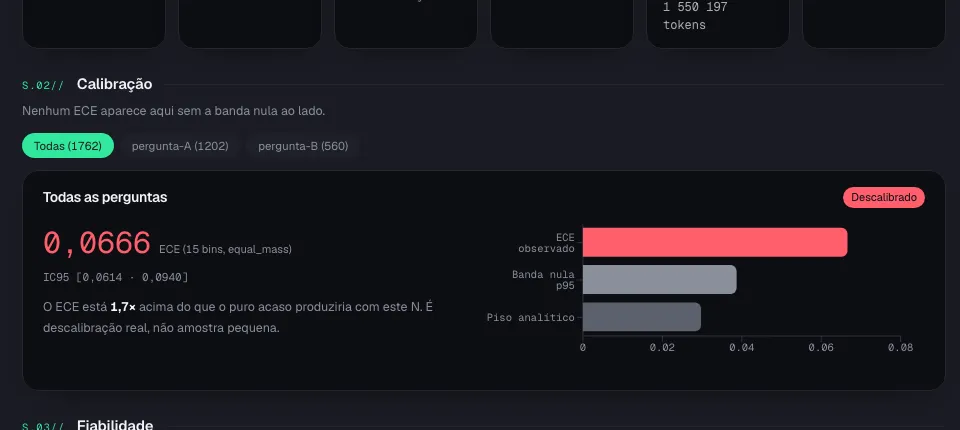
O painel que construí tem uma regra única: nenhum número de calibração aparece sem a banda ao lado, e o rótulo do meio diz “sem resposta ainda”, nunca “bom”. Um painel que mostrasse só o ECE seria pior do que nenhum, porque daria ar de medição a um palpite.
4. Comparar com o tonto e com ele próprio
Duas baselines, e sem elas um bom ECE não significa nada.
O preditor constante. Responde sempre a taxa base (“62% de probabilidade”, sempre). Tem ECE quase zero e resolução exactamente zero: nunca distingue nada. Se só olhares para a coluna do ECE, um preditor que não sabe nada ganha ao modelo. É a prova viva de que essa coluna não é critério.
O próprio modelo recalibrado. Pegas nas probabilidades dele e ajusta-las com uma regressão isotónica feita a partir dos teus rótulos. Se as probabilidades já vinham calibradas, isto não devia melhorar nada.
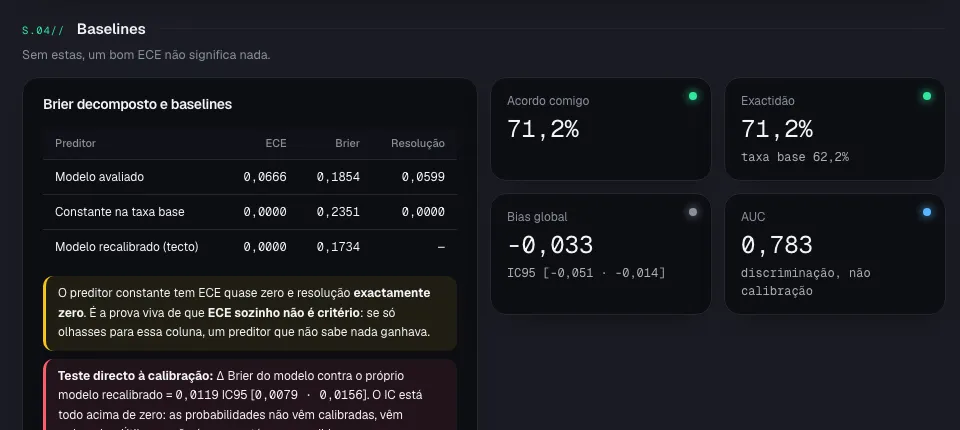
Foi aqui que a promessa caiu. A diferença de Brier entre o modelo e o próprio modelo recalibrado foi +0,0119, com intervalo de confiança a 95% de [0,0079 · 0,0156], todo acima de zero, e repetiu-se em três amostras independentes ficando mais forte em cada uma. Tradução: as probabilidades vêm ordenadas, não calibradas. Útil, e não é o que está a ser vendido.
O diagrama de fiabilidade diz a mesma coisa de outra maneira. Os pontos estão quase todos acima da diagonal: o modelo diz 0,30 onde a realidade é 0,55. Não é excesso de confiança, é falta dela, de forma sistemática.
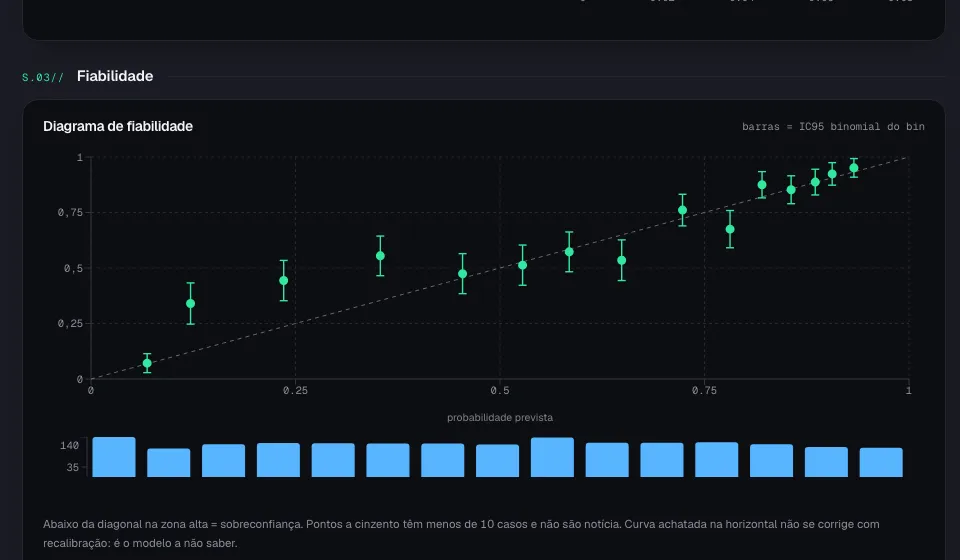
Duas coisas que quase nenhum diagrama traz e são obrigatórias: barras de erro binomial em cada ponto e um histograma de contagens por baixo. Sem elas não distingues miscalibração de amostra pequena, e um desvio enorme num bin com quatro casos não é notícia.
5. Decidir pelo ponto de operação, não pela métrica agregada
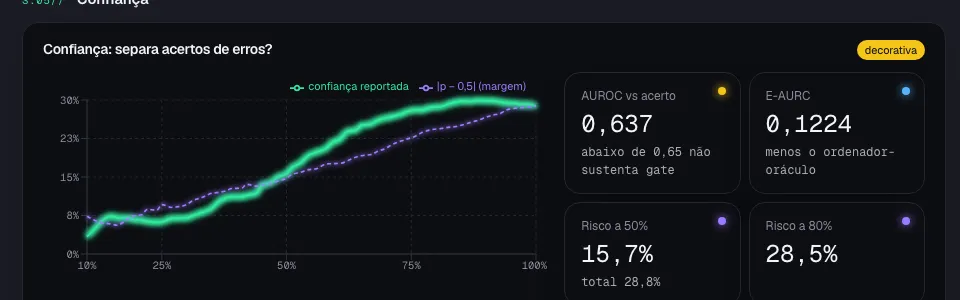
A métrica agregada pode dizer que a confiança do modelo é útil e, no ponto onde tu ias efectivamente cortar, ser inútil ou estar invertida. Aconteceu-me: a curva agregada dizia que a confiança ordenava melhor que a margem da própria probabilidade, mas um limiar de 0,8 abrangia 82% do corpus e tinha mais erro (31%) do que a zona de confiança baixa (23%).
O número operacional é o risco a cobertura fixa: “se mandar 30% para revisão humana, o erro do que fica automático cai de X para Y”. No meu caso, rever a metade pior baixou o erro de 30,9% para 18,5%. Isso é meia revisão poupada, medida. Um limiar não.
E o painel diz sempre quanto falta para a pergunta ter resposta, em vez de fingir que já tem:
O que encontrei
1.762 julgamentos sobre 1.202 documentos (560 deles julgados duas vezes, com réguas diferentes), em cerca de dois minutos de rede, por seis cêntimos. Latência mediana de 701 ms da Europa.
- Concordância com o meu juízo: 71,2%, com taxa base de 62,2%.
- Discrimina bem (AUC 0,783): sabe dizer qual é mais provável que qual.
- Não calibra: ECE 0,0666 contra uma banda nula de 0,040, ou seja 1,7 vezes acima do que o acaso produziria, com o intervalo de confiança inteiro acima da banda.
- Enviesado para baixo de forma significativa (bias −0,033, IC95 [−0,051 · −0,014]).
- Erra onde importa: 9% de erro nos casos óbvios, cerca de 32% nos ambíguos. Ou seja, é bom onde eu não preciso dele.
Houve ainda três divergências entre a documentação do fornecedor e a API a correr que só apareceram com a rede ligada: um campo documentado que não existe naquele tipo de pergunta, a impossibilidade de fixar a versão do modelo (a conta só expõe aliases móveis), e um desvio-padrão de 0,032 entre chamadas idênticas, três vezes o publicado. Código escrito contra documentação não é código verificado.
A parte que me apanhou
A meio do trabalho, com 400 casos, escrevi que estava provado que o modelo era descalibrado. O ECE estava 1,18 vezes acima da banda. Publiquei a conclusão internamente.
Com 560 casos, a conclusão desapareceu: o ECE desceu, a banda desceu menos, e o veredicto passou a “sem resposta ainda”. Só com 1.202 casos, e com o intervalo de confiança inteiro acima da banda, é que a afirmação voltou e se aguentou.
Uma leitura marginal não sobrevive a mais dados. O painel foi construído exactamente para impedir esse erro, e a primeira pessoa que apanhou a cometê-lo fui eu. Deixo isto escrito porque é a melhor prova que tenho de que o instrumento serve para alguma coisa.
O que se ganha, e quase nada vem do modelo
O trabalho de testar produziu mais valor do que a ferramenta testada:
- Uma lista de limpeza com nomes. Descobri que 38% da minha biblioteca de documentos não carrega, dentro do próprio ficheiro, a prova daquilo que afirma. Vinte e cinco desses têm um contador automático a afirmar uso que o ficheiro não sustenta.
- Um filtro determinístico que não erra. Documento sem uma única data lá dentro não tem prova: 29 em 29, humano e modelo de acordo. É uma pesquisa de texto, corre em milissegundos, custa zero. Passa a ser a primeira porta.
- Mil e duzentos rótulos meus, que servem com ou sem este fornecedor e que são o que permite treinar uma alternativa local mais à frente.
A regra que fica: ordena, tu decides. O modelo entra como acelerador de rotulagem e como ordenador de filas, nunca como fonte de probabilidade nem como dependência de runtime.
Limites desta análise
- Uma pergunta, um domínio, um corpus. Testei uma pergunta binária sobre documentos de texto em português e inglês. Não extrapoles para classificação de imagem, para outras línguas nem para outro tipo de pergunta.
- Os rótulos de referência são meus. Isso mede concordância com o meu critério, não correcção absoluta. Numa arbitragem cega com uma segunda pessoa, três das minhas regras revelaram-se mais apertadas do que as dela, o que mudou 26 rótulos. A conclusão sobre a calibração não mudou com a correcção, mas o número de concordância mudou.
- Parte das regras de arbitragem foi descoberta a olhar para casos que o modelo escolheu (aqueles em que discordou). A régua veio de uma pessoa às cegas e aplica-se por regra fixa a todo o corpus, o que é limpo, mas o caminho até ela foi enviesado. Por isso as rondas ficam separadas e nunca misturadas.
- Não medi calibração por subgrupo com N suficiente. Um modelo pode estar calibrado no agregado e descalibrado em cada segmento, por cancelamento.
- Não é uma auditoria de segurança do fornecedor, nem uma avaliação da categoria. É um teste de aceitação de uma carga de trabalho concreta.
Referências
- GPT-4 Technical Report, Figura 8 (calibração antes e depois do pós-treino) · https://arxiv.org/abs/2303.08774 (acedido 2026-09-17)
- Kadavath et al., Language Models (Mostly) Know What They Know · https://arxiv.org/abs/2207.05221 (acedido 2026-09-17)
- Tian et al., Just Ask for Calibration · https://arxiv.org/abs/2305.14975 (acedido 2026-09-17)
- Nixon et al., Measuring Calibration in Deep Learning · https://arxiv.org/abs/1904.01685 (acedido 2026-09-17)
- Kumar et al., Verified Uncertainty Calibration · https://arxiv.org/abs/1909.10155 (acedido 2026-09-17)
- Geifman et al., Bias-Reduced Uncertainty Estimation (AURC / E-AURC) · https://arxiv.org/abs/1805.08206 (acedido 2026-09-17)
- Hébert-Johnson et al., Calibration for the (Computationally-Identifiable) Masses (o paper da multicalibração) · https://arxiv.org/abs/1711.08513 (acedido 2026-09-17)